CatBoost e Text Features: suporte nativo para atributos textuais
O CatBoost já é conhecido por lidar bem com variáveis categóricas. Menos gente sabe que ele também processa colunas de texto nativamente, sem pipelines separados de NLP.
Você provavelmente já usou o CatBoost para variáveis categóricas. Mas sabia que ele também possui suporte nativo para texto?
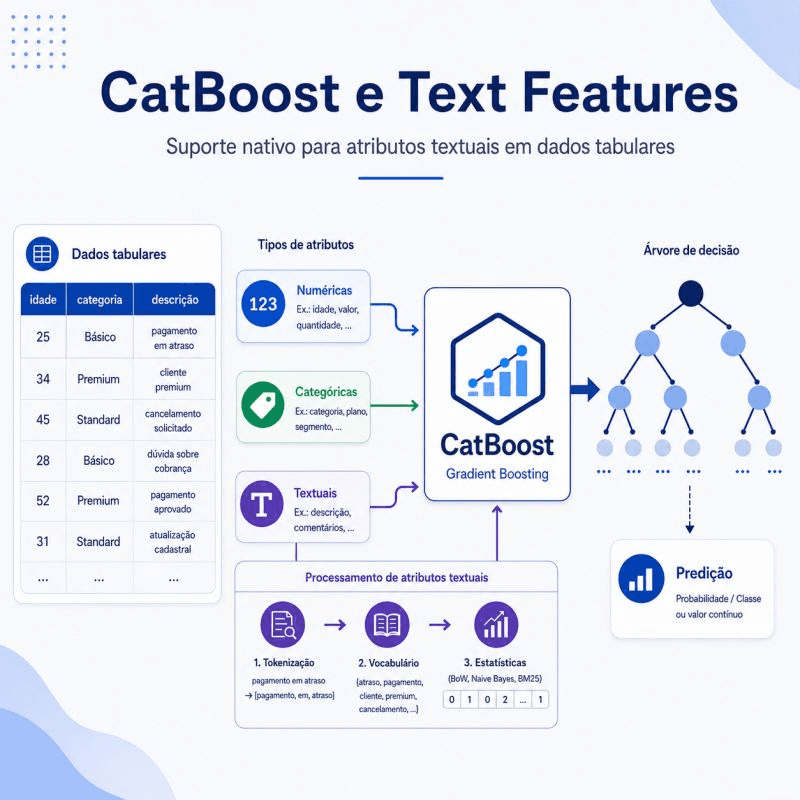
O CatBoost é um algoritmo de árvores baseado em gradient boosting, amplamente utilizado por lidar com variáveis categóricas sem exigir etapas tradicionais de pré-processamento, como one-hot encoding ou target encoding manual.
Em muitos problemas tabulares também existem colunas textuais, como descrições de produtos, observações, comentários ou até listas de itens. Essas informações frequentemente carregam sinal preditivo, mas acabam sendo descartadas ou exigem um pipeline separado para processamento, utilizando técnicas como TF-IDF ou embeddings.
No CatBoost, basta indicar quais colunas devem ser tratadas como texto durante a criação do modelo ou do Pool:
from catboost import Pool, CatBoostClassifier

train_pool = Pool(
    data=X_train,
    label=y_train,
    cat_features=["categoria"],
    text_features=["descricao", "comentario"]
)

model = CatBoostClassifier()
model.fit(train_pool)
A partir desse momento, o CatBoost realiza internamente etapas como tokenização, construção de um vocabulário a partir dos dados de treinamento e geração de representações estatísticas dos tokens. Essas representações são baseadas em abordagens como Bag-of-Words, Naive Bayes e BM25, sendo então utilizadas pelas árvores de decisão durante o treinamento.
Isso não significa que o CatBoost substitui embeddings ou modelos baseados em Transformers. O objetivo é diferente. Em vez de realizar uma compreensão semântica profunda do texto, ele utiliza representações estatísticas que conseguem capturar informações relevantes para muitos problemas tabulares.
Outro ponto interessante é que essas informações textuais passam a fazer parte do mesmo processo de aprendizado das demais variáveis. Dessa forma, o modelo pode aprender regras combinando atributos numéricos, categóricos e textuais, sem a necessidade de construir pipelines independentes para cada tipo de dado.
Na prática, isso também reduz o trabalho de feature engineering. Em muitos cenários, não é necessário construir manualmente etapas de tokenização, vetorização e integração dessas representações ao conjunto de dados, permitindo concentrar o esforço na experimentação e na avaliação dos modelos.
Como qualquer técnica de modelagem, essa não é uma solução universal. O ganho depende do problema, da qualidade das informações textuais e da quantidade de dados disponível. Ainda assim, quando um conjunto de dados possui atributos textuais, vale a pena incluir essa abordagem entre os experimentos e comparar seu desempenho, custo computacional e simplicidade de implementação com alternativas como TF-IDF, embeddings ou outros pipelines de processamento.
Referências
Ilustração gerada com auxílio do ChatGPT.