Testando o TabFM: uma comparação inicial com o CatBoost para dados tabulares
O Google lançou o TabFM, um Foundation Model para dados tabulares baseado em In-Context Learning. Comparei seu desempenho e custo computacional com o CatBoost em um problema de detecção de fraudes.
Recentemente, o Google lançou o TabFM, um Foundation Model para dados tabulares capaz de realizar tarefas de regressão e classificação. A proposta é interessante: utilizar um modelo pré-treinado em grandes volumes de dados sintéticos para realizar predições em novos conjuntos de dados por meio de In-Context Learning (ICL), reduzindo ou até eliminando a necessidade de treinamento específico e de otimização de hiperparâmetros para cada tarefa.
Esse lançamento chamou minha atenção. E decidi comparar o desempenho desta abordagem com modelos tradicionais.
Para investigar isso, comparei o TabFM com o CatBoost em um dataset sintético de detecção de fraudes em cartões de crédito, disponível no Kaggle. O conjunto de dados possui variáveis numéricas e categóricas, tornando o CatBoost uma boa referência para esse tipo de problema.
Metodologia
- Foram 3 execuções do TabFM e 3 execuções do CatBoost, utilizando as configurações padrão de cada modelo;
- Reinicialização do kernel entre cada execução para evitar interferências entre os testes;
- Utilização da mesma seed em todos os experimentos, garantindo que ambos os modelos fossem avaliados exatamente sobre os mesmos dados.
Resultados
TabFM — Precisão: 0,63 | Recall: 0,26 | F1-score: 0,37
CatBoost — Precisão: 0,68 | Recall: 0,23 | F1-score: 0,34
Os resultados foram bastante próximos. Neste experimento, o TabFM apresentou um F1-score ligeiramente superior, enquanto o CatBoost obteve maior precisão.
A principal diferença, entretanto, apareceu no desempenho computacional:
- Tempo médio de predição do TabFM: aproximadamente 23 minutos
- Tempo médio de predição do CatBoost: aproximadamente 12 milissegundos
- Tempo médio de treinamento do CatBoost: aproximadamente 43,5 segundos
Vale destacar que ambos os modelos utilizaram a mesma GPU durante os experimentos.
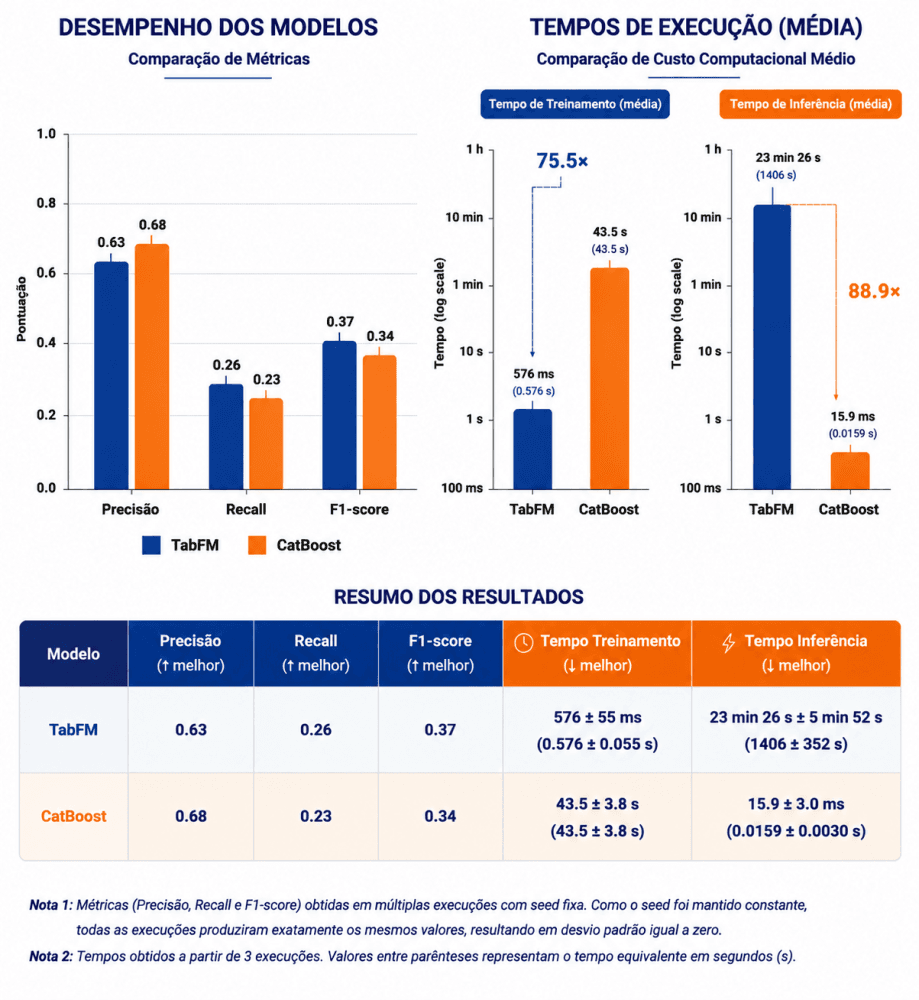
Na imagem acima, o valor apresentado como "tempo de treinamento" do TabFM corresponde, na prática, ao tempo gasto para leitura e preparação do dataset de contexto — já que o modelo não passa por um treinamento tradicional. Como ambas as abordagens usam o método fit(), mantive essa nomenclatura apenas para facilitar a comparação entre os dois.
Conclusões
Neste experimento, o TabFM apresentou um desempenho bastante semelhante ao do CatBoost, mesmo sem passar por uma etapa de treinamento específica para o problema. Esse resultado indica que a abordagem possui potencial e merece atenção, principalmente pela simplicidade do fluxo de inferência.
Por outro lado, o tempo de predição ainda representa um desafio importante. Embora eliminar a etapa de treinamento seja uma vantagem interessante, uma inferência que leva cerca de 23 minutos limita bastante sua aplicação em cenários que exigem respostas rápidas ou processamento em tempo real.
Este é apenas um experimento realizado em um único conjunto de dados. Avaliações em diferentes domínios, volumes de dados e tarefas serão importantes para entender em quais cenários modelos como o TabFM podem complementar ou até mesmo competir com algoritmos tradicionais para dados tabulares.