Artigos
Conteúdo técnico sobre Data Science, Machine Learning, Inteligência Artificial, MLOps e Escrita Científica.
Seu Data Drift pode estar alto. E seu modelo pode estar ótimo.
Data Drift não significa, necessariamente, degradação do modelo. Entenda por que uma mudança em P(X) nem sempre afeta a relação entre features e target.
Seu Data Drift pode não estar no modelo. Pode estar no pipeline.
Antes de retreinar um modelo depois de um alerta de drift, vale perguntar: o comportamento do negócio realmente mudou, ou foram apenas os dados?
Testando o TabFM: uma comparação inicial com o CatBoost para dados tabulares
O Google lançou o TabFM, um Foundation Model para dados tabulares baseado em In-Context Learning. Comparei seu desempenho e custo computacional com o CatBoost em um problema de detecção de fraudes.
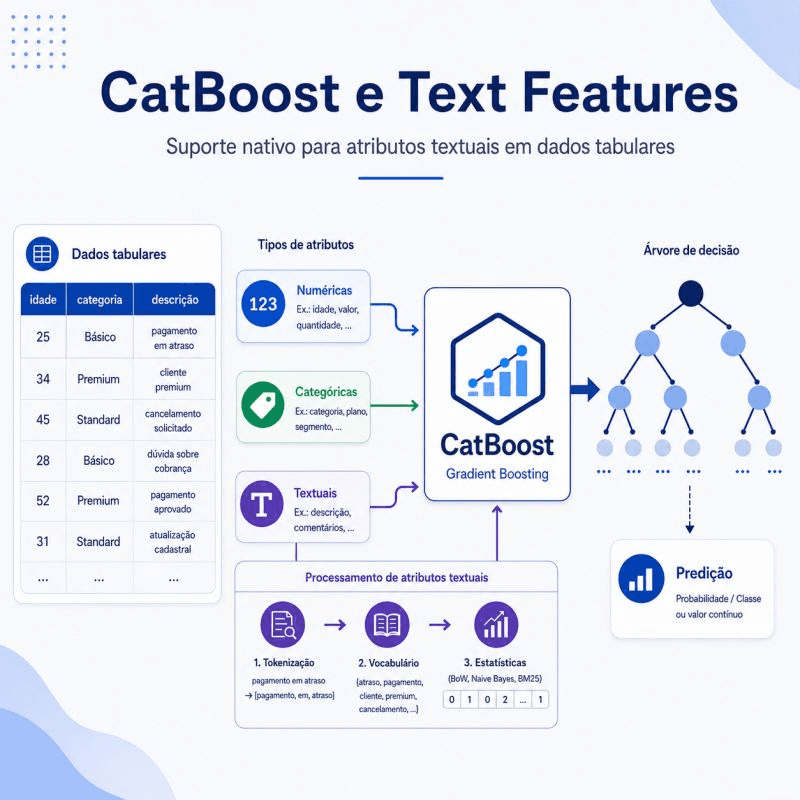
CatBoost e Text Features: suporte nativo para atributos textuais
O CatBoost já é conhecido por lidar bem com variáveis categóricas. Menos gente sabe que ele também processa colunas de texto nativamente, sem pipelines separados de NLP.