Seu Data Drift pode estar alto. E seu modelo pode estar ótimo.
Data Drift não significa, necessariamente, degradação do modelo. Entenda por que uma mudança em P(X) nem sempre afeta a relação entre features e target.
Anteriormente, falei sobre como um alerta de Data Drift poderia, na verdade, estar indicando um problema no pipeline de dados.
Mas tem outro ponto importante quando falamos de monitoramento: nem todo Data Drift é um problema.
Imagine que algumas features do seu modelo começaram a apresentar uma mudança relevante na distribuição depois que ele entrou em produção. Seu monitoramento de Data Drift acusa essa mudança, e a primeira coisa que você pensa é:
"Preciso retreinar o modelo."
Mas será que precisamos mesmo?
Quando falamos em Data Drift, normalmente estamos olhando para mudanças em P(X), ou seja, na distribuição das variáveis de entrada.
Só que uma mudança em P(X) não significa, necessariamente, que a relação entre as features e o target mudou. Essa relação está mais ligada ao P(Y|X). E aí está uma diferença importante: os dados podem mudar bastante e, ainda assim, o modelo continuar conseguindo fazer boas previsões.
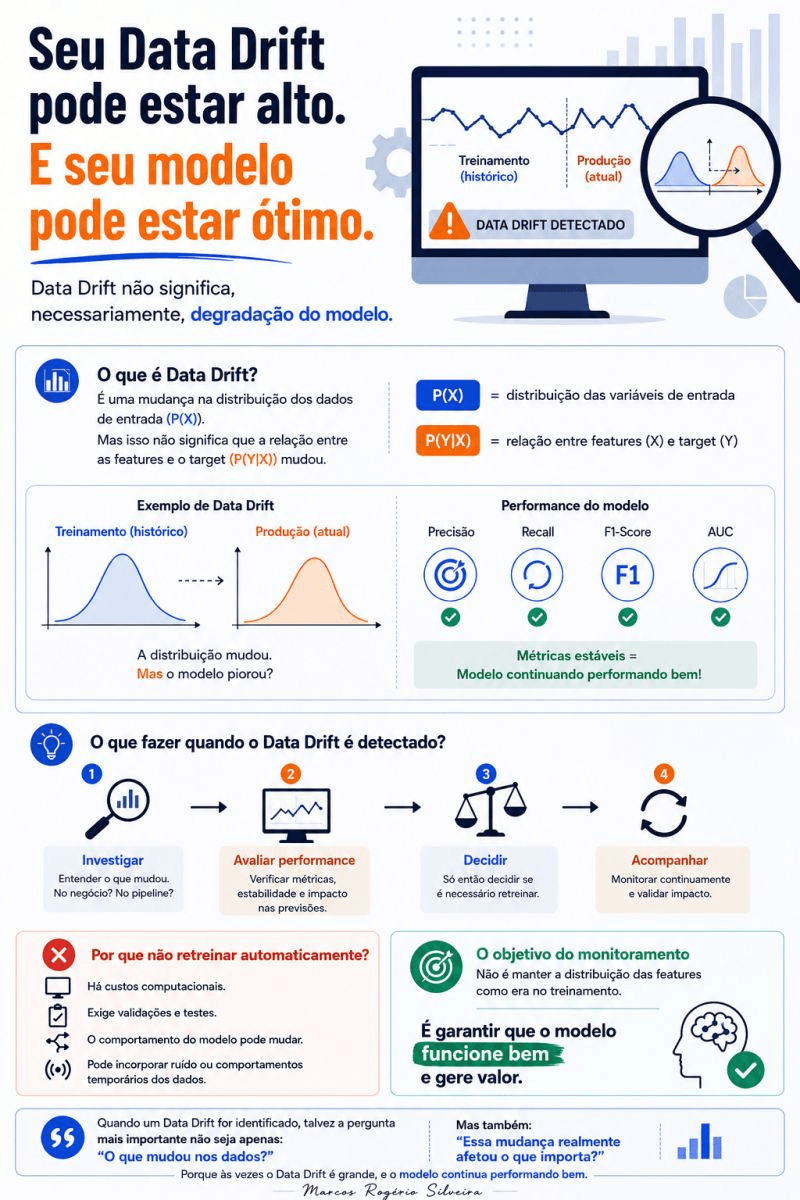
Por exemplo, podemos começar a receber um perfil diferente de clientes, fazendo com que a distribuição de algumas features mude bastante.
O drift existe.
Porém, se o modelo continua conseguindo separar bem as classes ou identificar os casos de maior risco, métricas de performance como Precisão, Recall, F1 ou AUC podem continuar praticamente estáveis.
Neste caso, houve Data Drift, porém não necessariamente houve degradação do modelo.
Por conta disso, não acho interessante tratar a identificação de Data Drift como uma regra automática de retreinamento.
Prefiro pensar que o Data Drift é um indicador importante, mas que, antes de tomar uma decisão, precisamos analisar a performance do modelo e entender o que realmente aconteceu.
Até porque retreinar um modelo sem necessidade não é gratuito. Há custos computacionais, é necessário fazer validações, o comportamento do modelo pode mudar e, dependendo do cenário, podemos até incorporar ruído ou comportamentos temporários dos dados.
No fim, o objetivo do monitoramento não deveria ser manter a distribuição das features exatamente como era no treinamento, mas sim garantir que o modelo continue funcionando bem e apresentando uma boa performance.
Por fim, quando um Data Drift for identificado, talvez a pergunta mais importante não seja apenas:
"O que mudou nos dados?"
Mas também:
"Essa mudança realmente afetou o que importa?"
Porque, às vezes, o Data Drift é grande e o modelo continua performando bem.
Ilustração gerada com auxílio do ChatGPT.