Seu Data Drift pode não estar no modelo. Pode estar no pipeline.
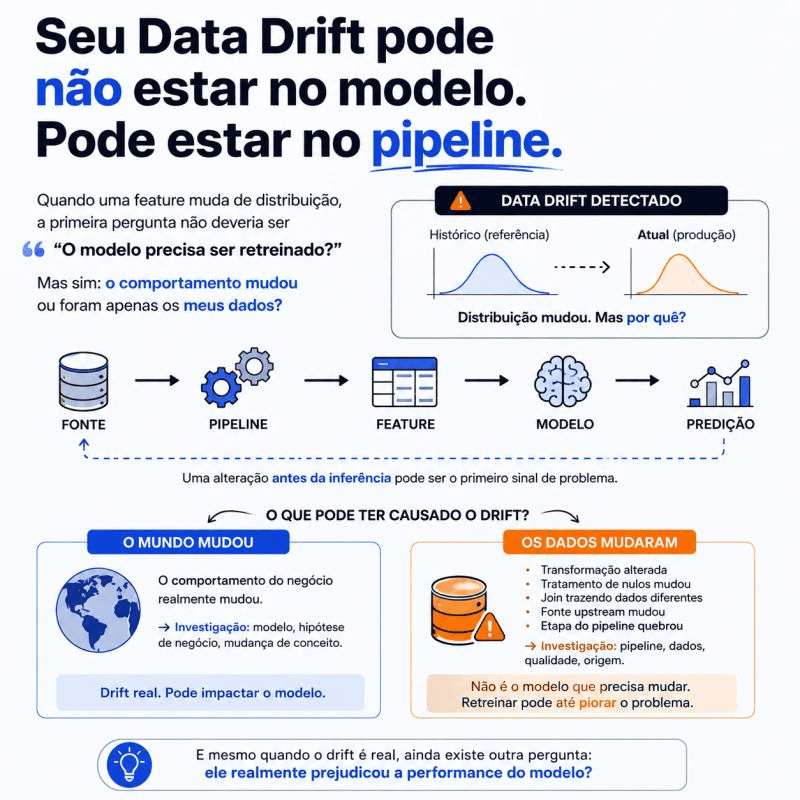
Antes de retreinar um modelo depois de um alerta de drift, vale perguntar: o comportamento do negócio realmente mudou, ou foram apenas os dados?
Monitorar Data Drift é algo extremamente importante quando trabalhamos com modelos em produção. É através desse tipo de monitoramento que conseguimos identificar mudanças nos dados e, dependendo da estratégia adotada, até disparar alertas ou processos de retreinamento.
Mas quando uma feature apresenta uma mudança de distribuição, uma das primeiras perguntas que pode surgir é:
"O modelo precisa ser retreinado?"
E a resposta pode ser: talvez não.
Uma mudança na distribuição de uma feature pode realmente indicar que o comportamento do negócio mudou. Mas também pode ter uma origem bem diferente.
Por exemplo:
- uma transformação foi alterada;
- o tratamento de valores nulos mudou;
- um join passou a trazer dados diferentes;
- uma fonte upstream mudou o comportamento;
- ou alguma etapa do pipeline simplesmente quebrou.
E esse é um ponto que acho interessante no monitoramento de Data Drift.
Quando olhamos apenas para a distribuição da feature, todas essas situações podem parecer a mesma coisa: os dados mudaram.
Por isso, vejo o monitoramento de Data Drift não apenas como uma forma de acompanhar a "saúde" do modelo, mas também como uma camada de observabilidade do pipeline de dados.
Afinal, antes de chegar ao modelo existe toda uma cadeia:
Fonte → Pipeline → Feature → Modelo → Predição
Uma mudança inesperada em uma feature pode ser o primeiro sinal de que alguma coisa aconteceu bem antes da etapa de inferência.
Então, antes de simplesmente retreinar um modelo depois de um alerta de drift, acho importante entender primeiro o que realmente mudou.
O comportamento do negócio mudou?
Ou foram apenas os meus dados que mudaram?
Se o comportamento realmente mudou, podemos estar diante de uma mudança no problema que o modelo precisa resolver.
Mas se o problema estiver no pipeline, retreinar o modelo provavelmente não vai resolver a causa. Pior: podemos acabar ensinando o modelo a reproduzir um problema que deveria ter sido corrigido nos dados.
E mesmo quando o drift é real, ainda fica uma outra pergunta: ele realmente prejudicou a performance do modelo?
Ilustração gerada com auxílio do ChatGPT.